简介
百亿亿次超算2026年迈入多极时代:中国灵晟LineShine以2.198 EFlops登顶TOP500,纯CPU路线突破2 EFlops,美欧E级系统并列,高性能计算与AI加速融合。
2026年6月23日,在德国汉堡举行的ISC 2026国际超算大会上,第67届TOP500榜单揭晓:中国自主研发的“灵晟(LineShine)”超级计算机以2.198 EFlops(每秒百亿亿次浮点运算)的持续双精度性能登顶,成为史上首台持续性能突破2 EFlops、且完全依靠CPU实现的系统。这是自2017年以来中国超算再度领跑TOP500,也宣告全球高性能计算进入“多极E级”新时代。
灵晟登顶:纯CPU路线的逆袭
LineShine部署于国家超级计算深圳中心,由深圳云计算中心研制,基于国产“灵昆(LingKun)”平台:304核LX2处理器、共计1379万核心、1.55 GHz主频,配自研“灵旗(LingQi)”互连与麒麟操作系统,功耗约42.2兆瓦,能效52.07 Gflops/W。它约达2.736 EFlops理论峰值80%,并在HPCG真实应用基准中以22.00 HPCG-Petaflop/s同样居首。
其最引人注目之处,是摒弃GPU、走纯CPU路线。在美方出口管制背景与AI系统普遍依赖加速卡的当下,LineShine以系统级全栈能力证明:不依赖GPU,同样能登顶科学计算之巅。TOP500联合创始人Jack Dongarra评价其为“令人印象深刻的系统”。
五强并立:E级计算走向多极
LineShine的登顶,使公开榜单中持续性能超1 EFlops的系统从4台增至5台,并首次在亚洲、北美、欧洲同时出现E级系统:美国“酋长岩”(El Capitan)1.809 EFlops居次,“前沿”(Frontier)1.353、“极光”(Aurora)1.012分列三四;德国“木星助推器”(JUPITER Booster)恰好1.000 EFlops,成为欧洲首台E级超算。
架构多样性同样空前:LineShine为国产CPU、El Capitan/Frontier为AMD Instinct加速、Aurora为英特尔平台、JUPITER基于NVIDIA Grace Hopper超级芯片。TOP500组织方指出,通往领导级计算“没有单一主导技术路线”,CPU、GPU、APU与定制加速器各行其道。
超智融合:E级算力的新范式
同一届ISC上,JUPITER展示了E级科学的多副面孔:以NVIDIA Grace Hopper驱动,训练脑显微结构基础模型CytoNet、以1公里分辨率模拟地球气候、支撑6G AI与50量子比特量子模拟。超算正从“跑仿真”演化为“数据密集型的科学发现基础设施”,即“HPC+AI for Science”。
不过专家也提醒,TOP500衡量的是传统科学计算基准,LineShine在更贴近AI的混合精度基准HPL-MxP中以7.92 EFlops列第四,说明其在低精度AI负载上并非最强;若大型云厂商提交其AI集群,排名或生变。但无论如何,公开E级阵营的扩容,本身就是高性能计算繁荣的信号。
从单机登顶到多极并立,2026年的TOP500折射出算力的全球再平衡。无论是纯CPU的LineShine,还是Grace Hopper的JUPITER,百亿亿次超算的竞赛已从“谁更快”升级为“谁能更好地融合科学计算与人工智能”。
相关推荐

绿氢与新能源存储:破解可再生能源看天吃饭难题
绿氢与新能源存储技术在2026年加速落地,内蒙古达拉特纯氢储能示范项目开工、江苏如东建成全国最大光氢储一体化工程,为破解可再生能源间歇性、实现长时消纳提供新路径。

碳捕集与气候科技:CCUS从概念验证走向工程化落地
碳捕集(CCUS)与气候科技在2026年加速从概念验证走向工程化落地,全球在运捕集能力达7300万吨/年、推进中项目约1300个,科技巨头开始直接采购碳捕集电力支撑AI算力。

可控核聚变迎投资与实验双突破:终极能源渐行渐近
可控核聚变在2026年上半年迎来投资与实验双突破,中国全高温超导托卡马克洪荒70实现1337秒稳态运行,中国环流三号达成双亿度,终极能源加速从实验室走向工程示范。

星链与卫星互联网:全球覆盖进入十亿级人口时代
星链(Starlink)2026年订阅用户突破千万、覆盖164个国家和地区、在轨卫星超9600颗,卫星互联网正加速从概念走向全球无缝覆盖,重塑偏远地区与航海航空通信格局。
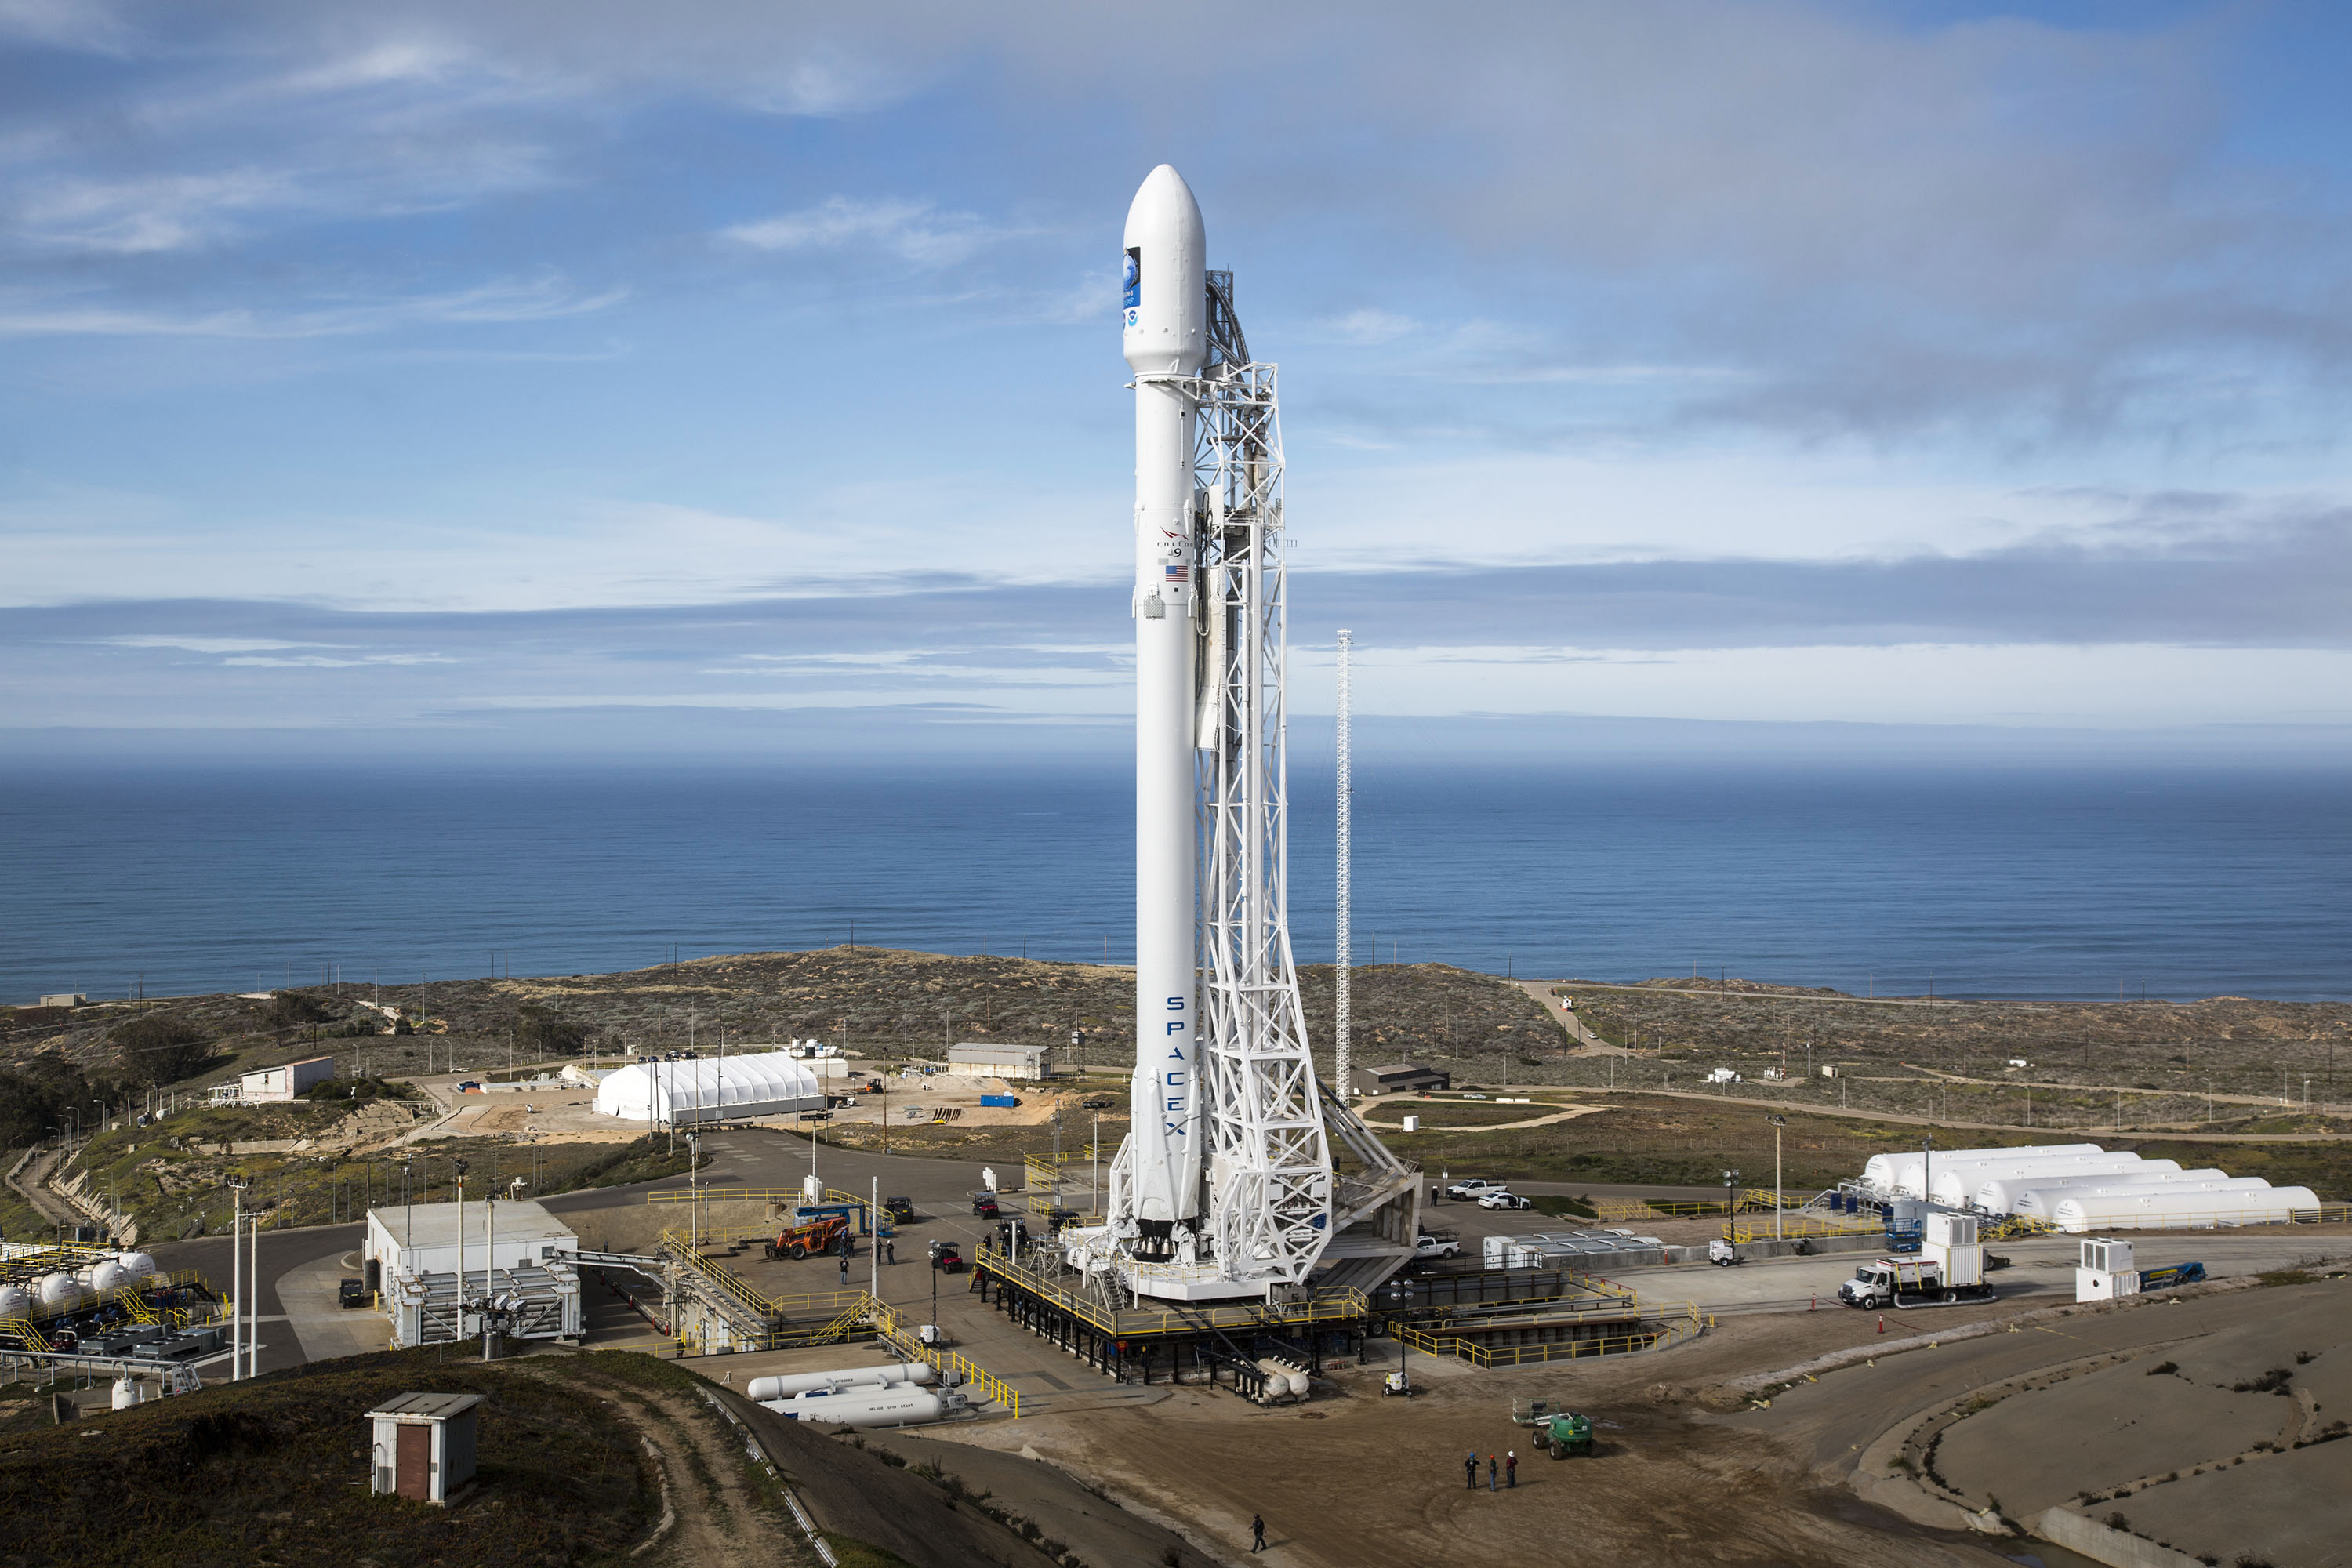
商业航天新跨越:可重复使用火箭走向常态化
可重复使用火箭在2026年迎来新跨越:SpaceX猎鹰9号助推器完成第35次复用并成功回收,复用走向常态化,持续拉低商业航天进入空间的成本门槛,加速卫星互联网与深空探索进程,标志着航天发射经济学发生根本性改变。
2026年物联网与数字孪生城市深入实践:重庆建成全域管线数字孪生,城市治理可感可控
物联网与数字孪生城市在2026年深入实践:重庆建成省级全域地下管线数字孪生系统,海量感知设备实时监测,'数字管线'赋能城市安全韧性治理,推动智慧城市从概念走向实景。